冒泡排序
引言
用C++实现的冒泡排序,复习复习。
思路
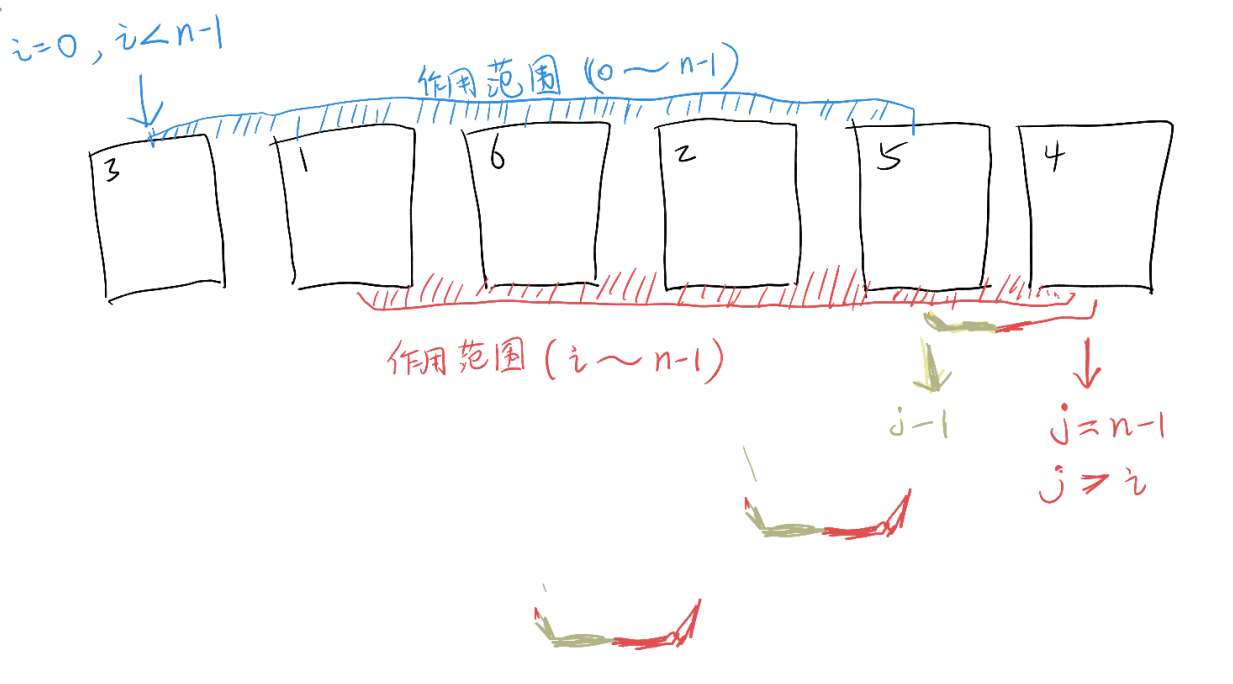
左边蓝色的索引,相当于本次循环要给这个坑位找到最小值。
右边红色的,相当于每次循环找最小值的过程,跑一圈就能找到要放在蓝色坑位的最小值。具体的呢,就是从最后开始,当前索引值和前面的值比较一下,相当于两两比较把更小的放在左边,这样走下去可以保证左边的一定比右边全部的小,跑到头自然就是最小的。
流程和下图一样: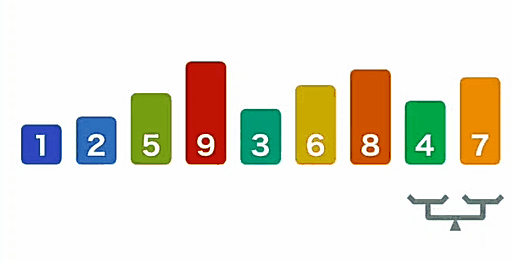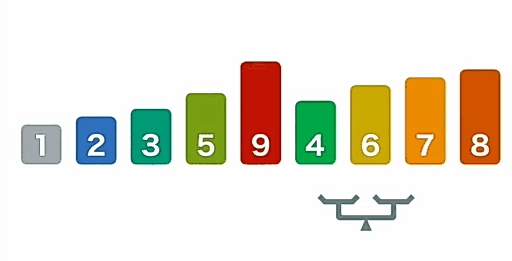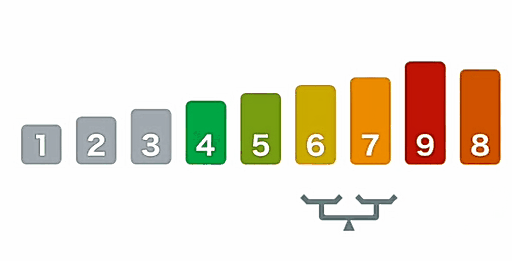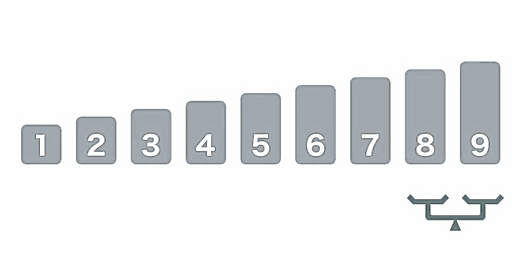
代码实现
冒泡排序
算法比较简单,直接上代码:
1 | /** |
特殊的是加了swapped判断,这个标记作用很简单,如果找最小值的流程走了一个循环,但是一个都没换,说明已经全部符合“从小到大”的顺序了(不然一定会发生交换),这样的话可以直接结束循环,避免后续多余的循环流程。
打印输出
1 | /** |
生成随机数
1 | /** |
这段代码有几个注意的点:
size_t: 是一个明确的类型别名 (Type Alias)。当你写下 size_t 时,你是在说:“我需要一个无符号整数类型,它必须大到足以容纳我这个系统上任何一个对象的大小。请给我这个类型。
auto 是一个类型推导 (Type Deduction) 关键字。当你写下 auto 时,你是在对编译器说:“我懒得写右边这个表达式返回的具体类型了,你那么聪明,帮我推断出来就行。”
至于说具体使用情况,我觉得AI比我总结的好:
总结一下:size_t 是一个语义化工具,用于表达“大小”这个概念;auto 是一个便利性工具,用于简化代码编写。在很多情况下,auto 会正确地推导出 size_t,但当你需要明确地向代码阅读者传达你的意图时(尤其是在 API 设计中),直接写出 size_t 是更好的选择。
下面是语法上的一些知识点:
- std::vector 的工作原理: vector 在内存中是一块连续的区域。当它的大小(size)达到其容量(capacity)时,如果再 push_back 一个新元素,vector 就必须:
- 寻找一块更大的新内存区域(通常是当前容量的 1.5 或 2 倍)。
- 将所有旧元素从旧地址复制或移动到新地址。
- 释放旧的内存区域。
这个过程称为**重新分配 (Reallocation)**,是相当耗时的操作。
- v.reserve(new_capacity) 的作用: 这个函数告诉 vector:“我预计很快就会需要至少 new_capacity 这么大的容量,请你提前一次性地把内存准备好。”
- 本行代码的含义: v.size() + static_cast
(n) 计算出最终 vector 将拥有的元素总数(现有元素数 + 即将添加的 n 个元素)。reserve 确保 vector 的容量至少能容纳下这么多元素。 - static_cast
(n): 这是一个类型转换。reserve 函数的参数是 size_t 类型,而 n 是 llint 类型。这里显式地将 n 转换为 size_t,是良好且安全的代码风格。
- static_cast
- 效果: 通过这一行代码,接下来的 for 循环中的 n 次 push_back 操作将不会触发任何耗时的内存重新分配,从而极大地提升了性能,尤其是在 n 很大时。
static std::random_device rd;
- std::random_device: 这是一个真随机数生成器。它通常从操作系统的熵池(比如硬件噪音、鼠标移动等不可预测的来源)获取一个高质量的、不可预测的随机数种子。它的缺点是生成速度可能较慢,所以我们一般只用它来生成一次种子。
- static: 这个关键字非常重要!它意味着 rd 这个对象只会在 generate_random_llint 函数第一次被调用时创建和初始化一次。之后的所有调用都会复用这个已经存在的 rd 对象。这避免了每次调用函数都去访问硬件熵池的开销。
static std::mt19937_64 generator(rd());
- std::mt19937_64 (Mersenne Twister 19937, 64-bit): 这是一个**伪随机数生成引擎 (Pseudo-random number engine)。它是一个复杂的算法,能够根据一个初始种子 (seed)**,快速地生成一系列在统计上看起来是随机的、高质量的数字序列。_64 表示它生成 64 位的随机数。
- generator(rd()): 这里是关键的连接点。我们调用 rd() 来从硬件获得一个真随机数,并用这个随机数作为伪随机数引擎 generator 的种子。
- static: 同样,generator 也被声明为 static。这意味着整个随机数生成引擎也只会在第一次函数调用时被创建和播种一次。
- 为什么这很重要? 如果不加 static,每次调用函数都会创建一个新的、用新种子初始化的 generator。如果函数在短时间内被多次调用,rd() 可能会返回相同的种子,导致每次调用都生成完全相同的随机数序列,这就失去了随机性!static 确保了我们始终在同一个随机序列上继续生成下去,保证了不同调用之间的随机性。
std::uniform_int_distribution
dis(0, 100); - std::uniform_int_distribution: 这是一个分布器 (Distribution)。引擎(如 mt19937_64)只负责生成原始的、均匀分布的随机比特流,而分布器则负责将这些原始比特流塑造成我们需要的特定数学分布和范围。
: 指定分布器生成的数据类型是 llint。 - dis(0, 100): 创建一个分布器实例 dis,它会将引擎生成的随机数映射到 [0, 100] 这个闭区间内,并且保证这个区间内的每个整数被抽中的概率是均等的。
- 注意: dis 没有被声明为 static。这意味着每次调用函数,都会创建一个新的分布对象。这通常是期望的行为,因为它允许你在不同的函数调用中使用不同的分布范围(虽然在这个固定例子中范围是 0 到 100)。如果范围总是固定的,把它声明为 static 也是可以的。
三者的关系如下:
- rd() (真随机源)
│
└─> (只在第一次) 提供一个种子
│
▼ - generator (伪随机引擎)
│ (被种子初始化后,内部状态不断变化)
└─> (每次调用) 提供一串原始的随机比特流
│
▼ - dis (分布器)
│ (接收原始比特流)
└─> 将其映射成 [0, 100] 区间内的最终随机数
主函数:
1 | /** |
复杂度分析
时间复杂度:
- 场景: 待排序的数组是无序的、随机的。
- 分析:
- 即使数组是随机的,冒泡排序的比较次数仍然是固定的 (n-1) * n / 2 次。
- 变化的只是交换的次数。在平均情况下,交换次数大约是比较次数的一半。
- 由于算法的执行时间主要由比较次数(即嵌套循环的次数)决定,所以平均时间复杂度仍然是 **O(n²)**。
空间复杂度:
- 冒泡排序是一种 原地排序 (in-place) 算法。
- 它不需要额外的数组或其他复杂的数据结构来辅助排序。
- 在元素交换时,它只需要一个临时的变量(temp)来暂存元素的值。
- 这个临时变量所占用的空间是固定的,不会随着数据规模 n 的增大而增大。
- 因此,其空间复杂度为 **O(1)**,表示常数级别的空间开销。
总结
冒泡本身比较简单,这次的最大收获在于随机数生成算法,这个写法很不错。
- 标题: 冒泡排序
- 作者: 起风了
- 创建于 : 2025-07-04 16:11:33
- 更新于 : 2026-09-26 11:50:56
- 链接: https://www.wangcac.me/2025/07/04/冒泡排序/
- 版权声明: 本文章采用 CC BY-NC-SA 4.0 进行许可。