基于AI翻译的模组汉化工具-7 Days To Die
开发背景
以前模组汉化都依靠机翻和人工,但是你也懂得,机翻和人工的优缺点显而易见:机翻嘛,快速简便,但是翻译质量参差不齐,长句子还好,偶尔甚至是频繁出现那种孤零零的单词时,它就无能为力了,你总不能想着让它结合语境把一个多义单词精准翻译出来,就算是人工也要联系上下文看看的。至于说人工,翻译一般情况下质量都还不错,但是速度实在是太太太太太慢了,大部分汉化制作组都是用爱发电,你也总不能让人家累死累活将爱发电视为工作,那不为难人家嘛。
但是现在AI崛起了,我于2023年11月开始使用Chatgpt,那时候版本还是Chatgpt 3来着,起初使用起来感觉很不错,我经常用它来写文字型的的作业(PS:大家可别学我),但是用久了会发现,这玩意格式其实相当固定,用多了一股子AI味,但是暂时也没发现比他更好用的,到今年4月份,Deepseek大火,我也简单用了用,刚开始还挺惊艳的,后来越来越难用,感觉数据被污染了,目前笔者主要用Gemini 2.5 Pro,笔者愿称目前综合实力最强。(PS:笔者最近几个月天天和Gemini思辨人生哲学,话说5月份泄露的KingFall我也用了,相当牛掰,但是接口被关了)。
笔者在家也一直运营着游戏服务器,最近几个月都在开七日杀,玩一些整合包,整合包就是囊括大量模组并且定制化流程使得模组相互协调,但是好玩的大型整合包很多都是国外开发者制作的,也就意味着大部分没有中文汉化,正巧AI现在也好用了,虽然Deepseek对话方面确实不太行,但是挺擅长那种固定型事务的,翻译就是其中之一(PS:“变废为宝”了属于是)
综上呢,笔者决定开发AI全自动汉化七日杀模组工具,以便能快速且保有高质量翻译水平的将大量模组汉化,从而随时能玩到七日杀最新的国外整合包。
需求分析
痛点
不能及时玩到最新的国外优质整合包,因为没有汉化!!!
分析
核心呢就是利用AI去全自动化翻译模组,由于整合包里模组数量很多,因此要能自动批量翻译,然后把翻译好的本地化文件打包成一个汉化模组,这样就不会因为模组本地化文件过多引起的复杂情况。
需求
- 利用AI实现七日杀模组的批量汉化
- 将汉化整合为汉化模组(PS:方便使用)
解决方案
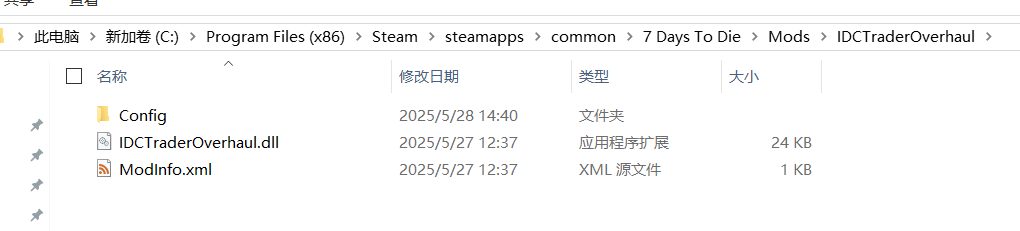
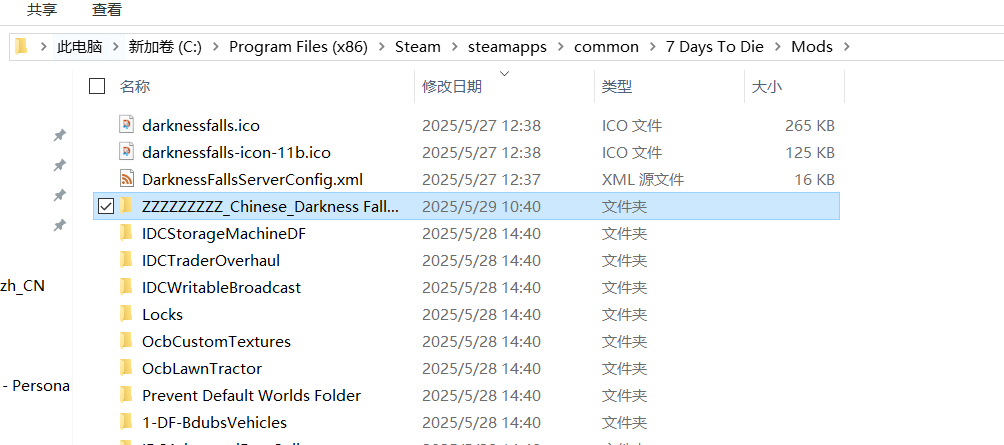
首先呢,七日杀的模组文件夹长下面这样,每个文件夹都是一个模组。
我们随便打开个模组,里面的结构如下:
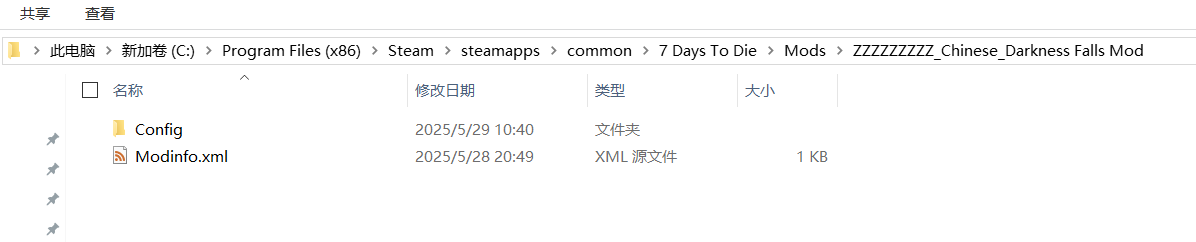
ModInfo就是该模组的详细信息,包括制作者版本啥的,Config就是模组的配置文件所在,通常本地化文件就在这个文件夹里,如下:
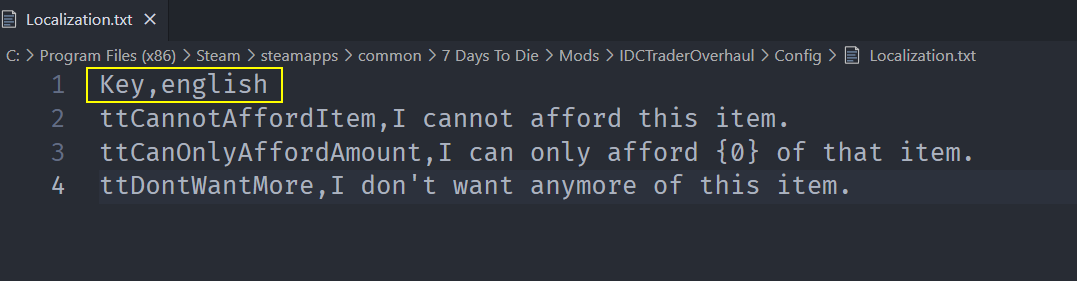
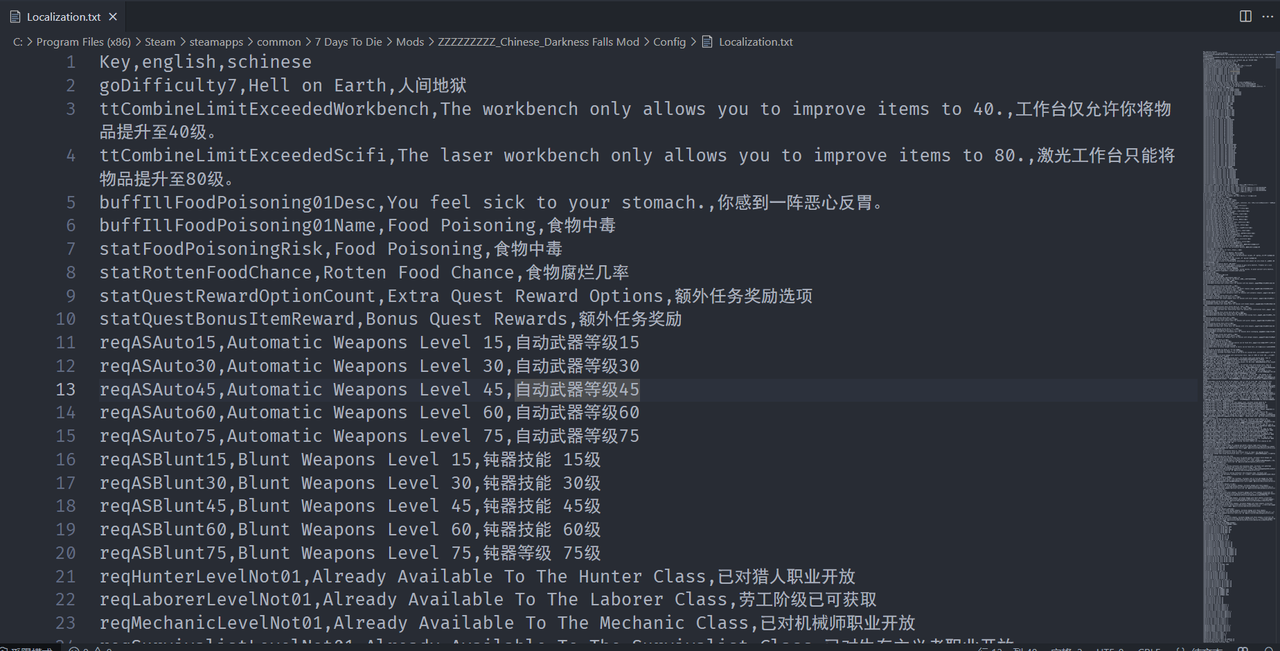
那个Localization就是本地化文件,通常包含该模组的所有文本。结构如下:
仔细观察,虽然是txt文件,但是结构却和csv几乎一毛一样,即第一行是表头,下面都是数据,因此我们只需要得到english列的英文文本,翻译后加到第三列,第三列表头为schinese,代表中文。
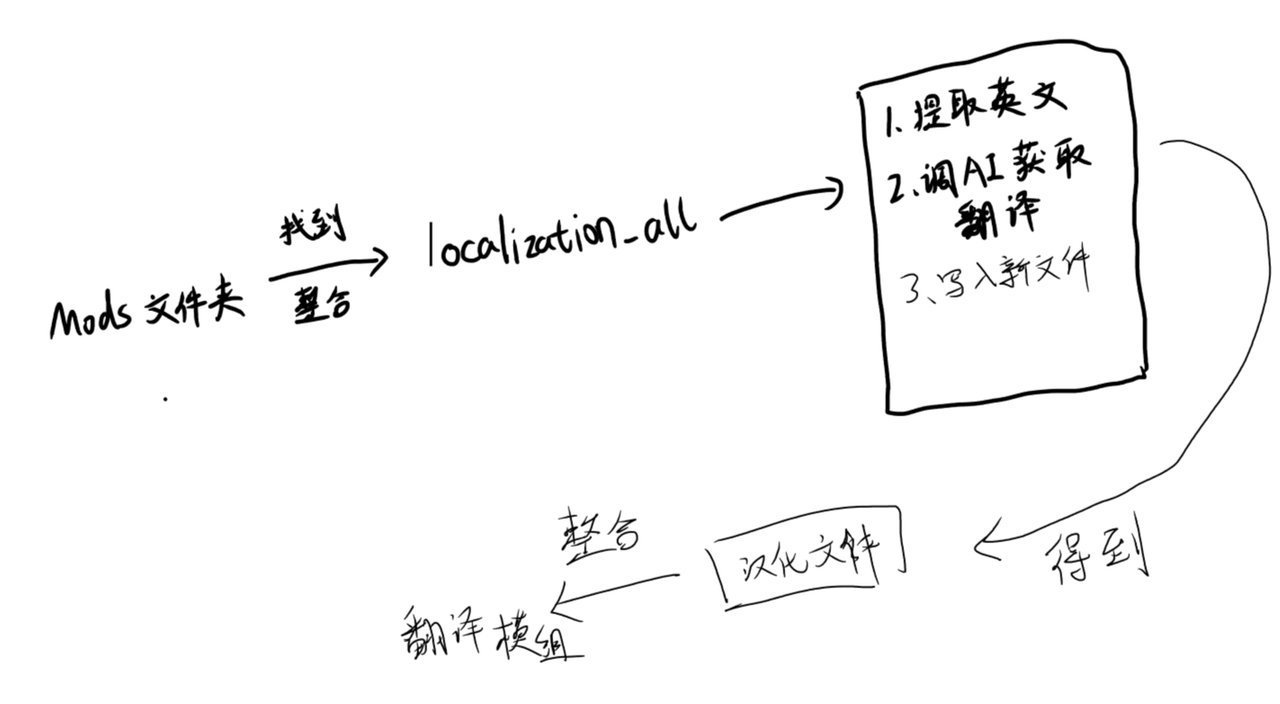
但是有个问题,模组这么多,而且这个本地化文件指不定在哪放着的,因此需要用脚本把所有的本地化文件搜罗到一块合并成一个文件,这样就好处理了。之后调用deepseek的api,将返回的翻译结果写入新文件,最后整合成新模组。
整体实现思路如下(PS:将就看吧):
技术选型
从需求来看就是个批处理然后再打包的过程,期间全自动化,这样的话直接用Python脚本即可。结合之前微信阅读答题脚本的经验,可以很快做出来。
另外额外需要的是,因为调用API等待系统回复需要时间,因此需要采用多线程技术,同时多线开跑,这样效率能提升多倍!
Python + AI + 多线程技术
难点与实现
其实这个脚本的难点不在于功能实现,而在于文本量巨大,一条一条翻译加上官方api巨他喵的慢就会导致要翻译好久好久,而且会出现万一特殊情况中断程序只能重头翻译,api也要钱的啊喂。
于是乎,重难点就在于提升效率的同时,优化流程,以防止哪怕特殊情况中断也能接上进度继续翻译。(PS:天杀的你敢信,最开始实验几万条数据花我10大洋嘞)
难点:优化流程
问题
一个整体文件,重头翻译,写入新文件,问题在于万一中途因为意外中断就需要重头翻译,浪费时间浪费软妹币,因此需要优化一下翻译流程。
解决思路
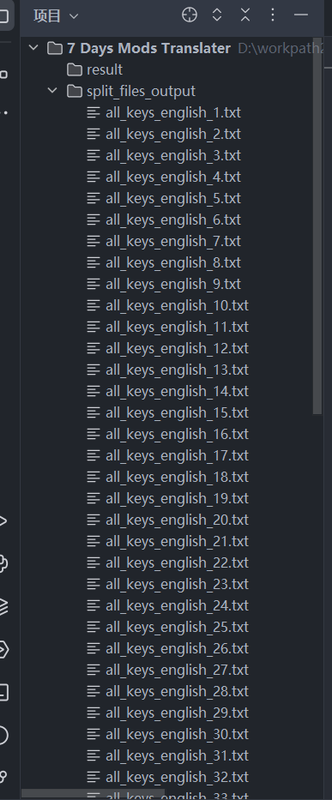
思来想去,想到一个好方法,把这整块疙瘩切割成多个小文件,然后逐个翻译后再整合成一个(PS:什么倒反天罡),这样即使中途因为意外终止,只需要在开始翻译前对照下原始的小文件列表和翻译后的文件列表,根据标号一一对应检查,就能知道哪些已经翻译哪些还没翻译,这样就可以避免频繁重复翻译导致的额外时间和金钱花销,节省成本和时间。
思路图如下:
实现
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
| def split_csv_like_file(source_filepath, output_folder, lines_per_file, include_header=True):
"""
将一个结构类似CSV的文件按指定行数分割成多个小文件。
Args:
source_filepath (str): 源文件的路径。
output_folder (str): 分割后文件存储的文件夹路径。
lines_per_file (int): 每个小文件包含的数据行数 (不包括表头)。
include_header (bool): 是否在每个分割文件中包含表头。
"""
if not os.path.exists(source_filepath):
print(f"错误: 源文件 '{source_filepath}' 未找到。")
return
os.makedirs(output_folder, exist_ok=True)
print(f"输出文件夹: '{os.path.abspath(output_folder)}'")
base_filename, file_extension = os.path.splitext(os.path.basename(source_filepath))
try:
with open(source_filepath, 'r', newline='', encoding='utf-8') as infile:
csv_reader = csv.reader(infile)
header = None
if include_header:
try:
header = next(csv_reader)
if not header:
print(f"警告: 源文件 '{source_filepath}' 的表头为空。")
except StopIteration:
print(f"错误: 源文件 '{source_filepath}' 为空或无法读取表头。")
return
file_count = 1
line_count_in_current_file = 0
current_outfile = None
csv_writer = None
for row_number, data_row in enumerate(csv_reader, 1):
if not data_row:
continue
if current_outfile is None or line_count_in_current_file >= lines_per_file:
if current_outfile:
current_outfile.close()
print(f" 已写入 {line_count_in_current_file} 行到 {current_output_filepath}")
output_filename_part = f"{base_filename}_{file_count}{file_extension}"
current_output_filepath = os.path.join(output_folder, output_filename_part)
print(f"创建新文件: {current_output_filepath}")
current_outfile = open(current_output_filepath, 'w', newline='', encoding='utf-8')
csv_writer = csv.writer(current_outfile)
if include_header and header:
csv_writer.writerow(header)
line_count_in_current_file = 0
file_count += 1
csv_writer.writerow(data_row)
line_count_in_current_file += 1
if current_outfile:
current_outfile.close()
print(f" 已写入 {line_count_in_current_file} 行到 {current_output_filepath}")
print(f"\n文件分割完成。共生成了 {file_count - 1} 个小文件。")
except FileNotFoundError:
print(f"错误: 源文件 '{source_filepath}' 在处理过程中未找到。")
except Exception as e:
print(f"处理文件时发生错误: {e}")
if current_outfile and not current_outfile.closed:
current_outfile.close()
|
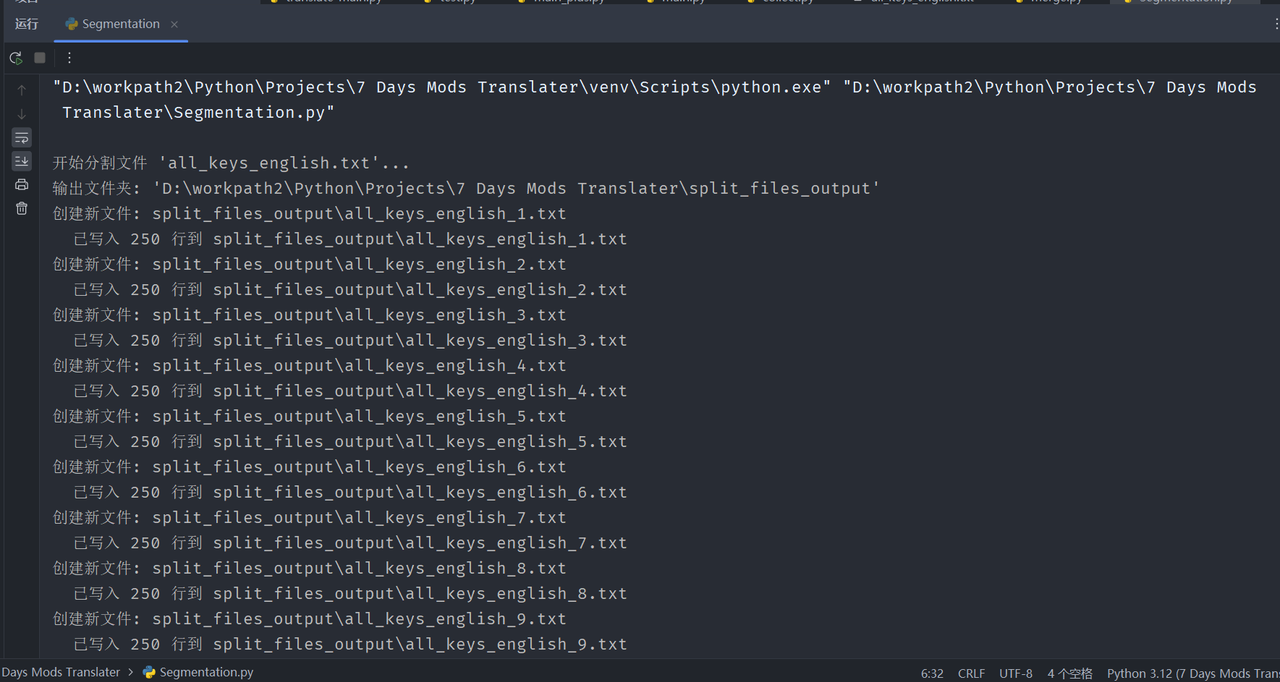
这个方法可以将整体按照指定行数切分成多个子文件并编上序号。其实核心就是能快速定位中断的地方,本来一个大块文件翻译一半你也不清楚翻译到哪里了,那还怎么接上。切分成块以后,只需要看看哪些块被翻译了,排除掉,剩下的就是没翻译的。
成果
将整块文件分成n个子文件,最后在合并。
极大减少了时间成本以及资金。
难点:提升效率
问题
废话不多说,上图,你就看这一万多条数据,deepseek官方api平均反应5s,翻译完都天荒地老了。问题就是慢慢慢慢。
解决思路
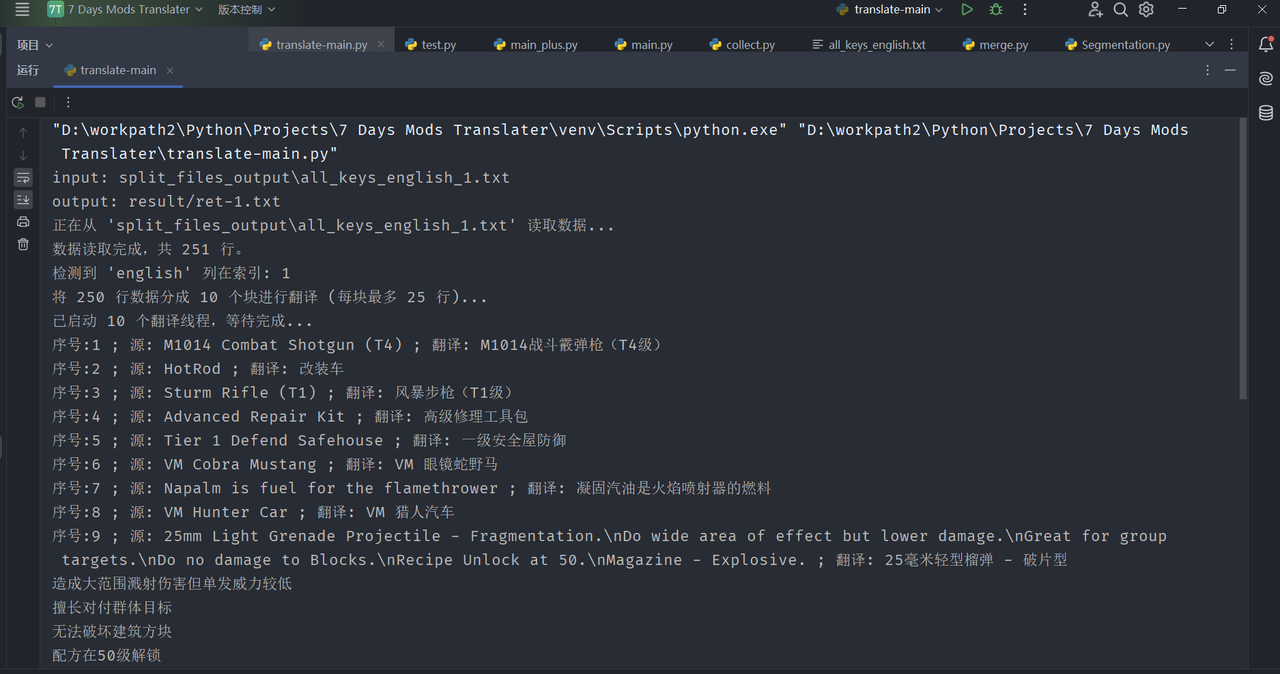
原思路的话就是一个一个翻译,太慢了。显然这个脚本执行的翻译属于IO密集型任务,比如等待Deepseek返回结果(等待服务器响应)、文件读写,之前是一个一个读取,那么可以利用多线程,将要翻译的文本块分成n个块,用n个线程同时去跑,最后把结果拼接到一块就行了,这样效率就提高了n倍。
实现
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
| def main():
files_path = get_first_level_files_pathlib("split_files_output")
for input_filepath in files_path:
input_filepath = str(input_filepath)
start_time = time.time()
output_filepath = f"result/ret-{input_filepath.split("_")[-1].split(".")[0]}.txt"
print(f"input: {input_filepath}\noutput: {output_filepath}")
print(f"正在从 '{input_filepath}' 读取数据...")
all_data = read_csv_file(input_filepath)
if not all_data:
print("未能读取到数据,程序退出。")
return
print(f"数据读取完成,共 {len(all_data)} 行。")
header = all_data[0][:]
data_to_translate = all_data[1:]
if not data_to_translate:
print("没有数据需要翻译(除了表头)。")
header.append("schinese")
write_csv_file([header], output_filepath)
return
english_column_index = -1
try:
if 'english' in [h.lower().strip() for h in header]:
english_column_index = [h.lower().strip() for h in header].index('english')
print(f"检测到 'english' 列在索引: {english_column_index}")
else:
print("警告:表头中未找到 'english' 列,将使用最后一列作为翻译源。")
except ValueError:
print("警告:在确定 'english' 列索引时出错,将使用最后一列。")
num_rows_to_translate = len(data_to_translate)
chunk_size = (num_rows_to_translate + NUM_THREADS - 1) // NUM_THREADS
if chunk_size == 0 and num_rows_to_translate > 0:
chunk_size = 1
effective_num_threads = num_rows_to_translate
elif chunk_size == 0 and num_rows_to_translate == 0:
print("没有数据需要翻译。")
header.append("schinese")
write_csv_file([header], output_filepath)
return
else:
effective_num_threads = NUM_THREADS
threads = []
chunk_results_collectors = [[] for _ in range(effective_num_threads)]
print(
f"将 {num_rows_to_translate} 行数据分成 {effective_num_threads} 个块进行翻译 (每块最多 {chunk_size} 行)...")
current_original_index = 0
for i in range(effective_num_threads):
start = i * chunk_size
end = min((i + 1) * chunk_size, num_rows_to_translate)
if start >= end:
break
chunk = data_to_translate[start:end]
thread = threading.Thread(
target=translate_chunk,
args=(chunk, chunk_results_collectors[i], i, english_column_index, start)
)
threads.append(thread)
thread.start()
current_original_index = end
print(f"已启动 {len(threads)} 个翻译线程,等待完成...")
for i, thread in enumerate(threads):
thread.join()
print(f"线程 {i} 已完成。")
print("所有翻译线程已完成。正在合并结果...")
final_translated_texts = []
for chunk_result_list in chunk_results_collectors:
final_translated_texts.extend(chunk_result_list)
header.append("schinese")
output_data = [header]
if len(final_translated_texts) != num_rows_to_translate:
print(
f"警告: 翻译结果数量 ({len(final_translated_texts)})与待翻译行数 ({num_rows_to_translate}) 不匹配! 请检查日志。")
min_len = min(len(final_translated_texts), num_rows_to_translate)
for i in range(min_len):
row_copy = data_to_translate[i][:]
row_copy.append(final_translated_texts[i])
output_data.append(row_copy)
if num_rows_to_translate > min_len:
for i in range(min_len, num_rows_to_translate):
row_copy = data_to_translate[i][:]
row_copy.append("[翻译结果缺失-长度不匹配]")
output_data.append(row_copy)
else:
for i in range(num_rows_to_translate):
row_copy = data_to_translate[i][:]
row_copy.append(final_translated_texts[i])
output_data.append(row_copy)
write_csv_file(output_data, output_filepath)
end_time = time.time()
print(f"所有操作完成!总耗时: {end_time - start_time:.2f} 秒")
|
成果
将文件中的文本行分成n个块,利用多线程同时进行翻译任务。
将效率提升了n倍。(PS:当然这个n是有限度的,调个10就差不多了)
项目演示
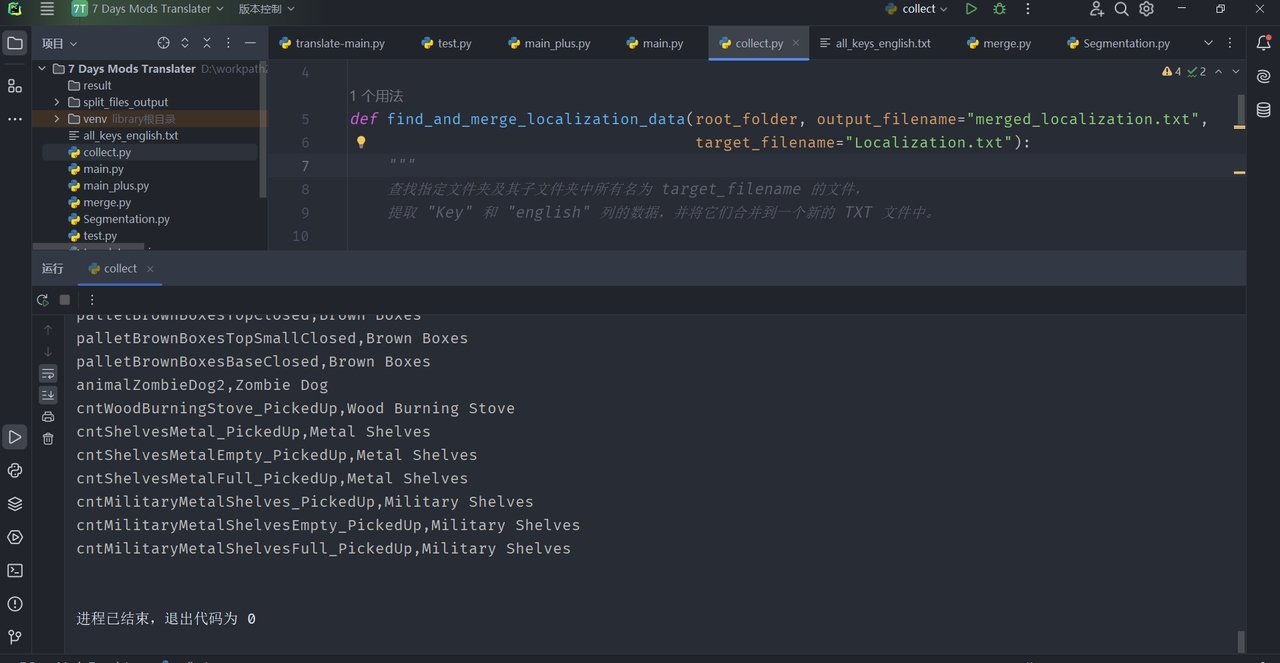
收集与整合本地化文件
将整合好的本地化文件切分为多个子文件
翻译
结果
只需要将整合好的汉化模组放入mods文件夹即可实现汉化
效益
- 模组快速高效批量自动化,大大提升了玩家的游戏体验(因为能随时玩到最新的优质整合包,不用做急急国王了)
- 利用多线程技术将原有汉化效率提升了10倍(就是这么夸张,之前1条线跑,现在10条线,理论上还能更快)
复盘
本次最大的收获在于对多线程的运用,因为日常很多任务都是IO密集型的,在cpu资源充裕的情况下,尽可能提高线程数可以大大提高批量处理的效率。
下面复盘下python多线程的使用:
1
2
3
4
5
6
7
| thread = threading.Thread(
target=translate_chunk,
args=(chunk, chunk_results_collectors[i], i, english_column_index, start)
)
threads.append(thread)
thread.start()
current_original_index = end
|
threading.Thread(…): 这是在创建一个 Thread 类的实例,也就是一个线程对象。此时线程只是被定义好了,还没有开始运行。
target=translate_chunk: 这是最重要的参数。它告诉线程,当它启动后,应该去执行哪个函数。在这里,它要去执行一个名为 translate_chunk 的函数。
args=(…): 这个参数指定了传递给 target 函数(也就是 translate_chunk 函数)的参数。它必须是一个元组(tuple)。
- chunk: 可能是要翻译的一小段数据(比如几行文本)。
- chunk_results_collectors[i]: 从名字看,这可能是一个列表或字典,用来收集各个线程的处理结果。[i] 表示当前这个线程应该把它的结果存放在这个“结果收集器”的第 i 个位置,这样可以保证结果的顺序和原始数据块的顺序一致。
- i: 当前块的索引号,可以用作线程的唯一标识。
- english_column_index: 可能是数据块(chunk)中需要翻译的英文所在的列的索引。
- start: 可能是这个数据块在原始完整数据中的起始位置索引。
threads: 这里显然有一个预先定义好的列表,叫做 threads。
threads.append(thread): 把刚刚创建的线程对象 thread 添加到这个列表中。这么做的目的是为了方便管理。之后,主程序可以通过遍历这个列表来检查所有线程的状态,或者等待所有线程都执行完毕。
thread.start(): 这是启动线程的关键命令。一旦调用这个方法,一个新的操作系统级线程就会被创建,并开始执行 target 指定的 translate_chunk 函数。
重要的是:主线程在调用 thread.start() 后不会等待 translate_chunk 函数执行完成,而是会立即继续执行下一行代码。这就是多线程的“并发”特性。
这行代码是在主线程中执行的,紧接着 thread.start() 之后。
它表明这段代码很可能在一个循环里。end 变量很可能是当前 chunk 在原始数据中的结束位置。这行代码的作用是更新下一个 chunk 的起始位置,为下一次循环做准备。
这段代码是典型的“生产者”模式:主线程在一个循环中不断地“生产”任务(创建并启动线程),而不需要等待上一个任务完成。这极大地提高了处理 I/O 密集型任务(如网络请求、文件读写)的效率,因为线程在等待 I/O 时,其他线程可以继续使用 CPU。